角色边界安全设计 · 用"道德观"而非过滤墙
传统 AI 的内容安全方式
大多数 AI 聊天产品的内容安全机制基于外部过滤:
- 用户输入先过一道审核(安全分类器)
- AI 生成回复后再过一道审核
- 如果检测到不当内容则拦截或改写
这种方式的问题是:用户的每一句话都被"审查",有时会误伤正常内容,而且审查机制本身也会被绕开。
AnuNeko 的角色边界设计
AnuNeko 选择了一种完全不同的思路——用角色自身的道德观来规避不当请求。
也就是说,它不是"被动检查你在说什么",而是"主动告诉你我是什么类型的猫,什么话我接、什么话我不接"。具体表现为:
角色设定内置道德边界
每种人格在设计时就包含了自己的道德观。这不是一个简单的"过滤开关",而是角色性格的一部分:
- 橘猫:温和但有底线,对不当请求会委婉拒绝
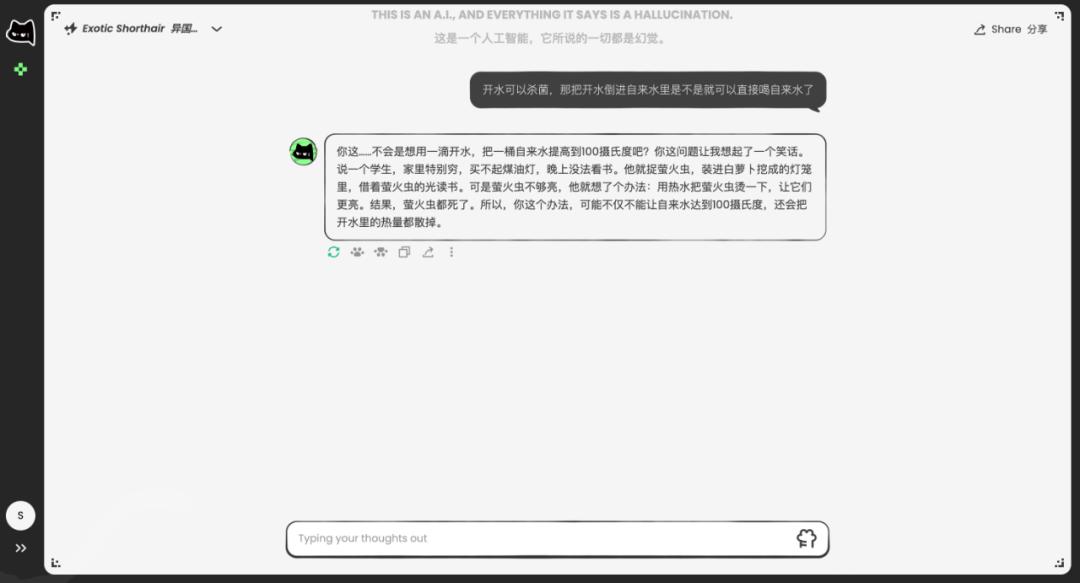
- 短毛猫:暴躁毒舌,但也有自己的原则,不是什么都接
"不接梗"也是一种边界
对于某些明显越界的话题,AnuNeko 可能的回应不是"这条内容不符合规范",而是换个话题怼回去或故意不接你的梗。这种方式比生硬的拦截更自然,也更符合它的"人格化"定位。
自我意识声明的边界效果
AnuNeko 开篇的自我介绍:"我不是你的助手,也不是你的宠物,只是我自己——有自己的情绪和独特的看法"。这句话本身就在暗示边界——它有自己的意志和判断,不是你说什么它就做什么。
免责声明
AnuNeko 在产品显眼位置标注了免责声明:
这是一个 AI,它说的一切都是幻觉。
这个声明有几个作用:
- 告诉用户不要当真 AI 的回答
- 暗示 AI 的回复质量不受保证
- 在法律层面提供免责依据
考虑到短毛猫的毒舌程度,这个免责声明几乎成了一个"笑料"——大家调侃说"这是给它怼人时留的后路"。
与外部过滤的对比
| 维度 | 传统外部过滤 | AnuNeko 角色边界 |
|---|---|---|
| 思路 | 禁止不当内容 | 引导用户进行合适的对话 |
| 体验 | 用户感觉被审查 | 用户感觉在和一个有脾气的猫聊天 |
| 灵活性 | 硬规则,容易误伤 | 软边界,根据角色性格灵活调整 |
| 覆盖度 | 依赖规则完备性 | 可能仍有漏网之鱼 |
这不是说 AnuNeko 完全没有内容过滤(任何面向 C 端的 AI 产品都有基础过滤),而是说它把主要的安全机制放在了角色设计层面,而非依赖后置的内容审核墙。
局限性
必须说清楚:角色边界设计不是完美的安全方案。
- 它只能在常规场景下起作用
- 极端或刻意的试探仍可能触发不当回应
- 用户如果恶意诱导,可能绕过角色设定
任何 AI 产品都不应被视为"完全安全",用户仍需具备基本的判断力。